有効なサイトマップでも「couldn’t fetch」が出るとGoogleが認めた
出典によると、Splitt氏は、「couldn’t fetch」のエラーを受け取る人の多くが、有効で、robots.txtから適切にリンクされたXMLサイトマップを持っており、Googleがサイトマップを取得できない技術的な理由は見当たらない、と認めました。Montti氏は、Googleの中の人たちがこの問題とユーザーの不満を把握している、というのがここでの要点だと書いています。
Splitt氏の問いかけは次のようなものでした。
So it’s valid, it’s publicly accessible, and it’s linked from the robots.txt. And yet Search Console says can’t fetch sometimes.
日本語にすると「つまり有効で、公開されていてアクセスでき、robots.txtからリンクされている。それなのにSearch Consoleは、ときどき取得できないと表示する」という内容です。同氏は、XMLのような構造化された形式は検証できるのがよいところだ、とも述べています。
重要なのは、形式が正しいかは自分で確かめられるのに、それでもエラーが出る場合があるとGoogle側が認めた点です。
理由1:サーバー側の負荷(ホストロード)
Mueller氏は、フォーラムでこのエラーについての質問をよく目にすると述べ、このエラーメッセージには2つの理由があると説明しました。
1つ目は、サーバーのホストロード(負荷)の問題で、Googleが本当にサイトマップにアクセスできない場合です。出典はこれを、サーバーに届くページへのリクエストが多すぎて、求められたリソースを返せない状態だと説明しています。また、サーバーがクロールの負荷に耐えられないことを意味する場合もあるとしています。
Mueller氏の説明の中心は次の部分です。
And it could be the case that we don’t have any time to crawl this sitemap file because we’re too busy with other things.
日本語にすると「そして、ほかのことで忙しすぎて、このサイトマップファイルをクロールする時間がまったく無い、ということもありうる」という内容です。同氏は、その場合も実際に取得する時間が無かったので「couldn’t fetch」として示すことになる、と続けています。
Montti氏はこれに加えて、Mueller氏は触れていないとしたうえで、夜間に正規・非正規のクローラーが一度に数千件のリクエストでサイトを叩き、サーバーが500エラーを返すことでもホストロードの問題は起きうると書いています。500エラーのレスポンスはSearch Consoleで確認でき、アクセスできるならサーバーのログファイルでも確認できると同氏は書いています。これはGoogleの説明ではなく、出典の筆者の補足です。
理由2と3:クロールの需要とサイトの品質
Mueller氏が挙げた2つ目の理由は、同氏が「crawl demand」(クロールの需要)と呼んだものです。Montti氏は、これは実際には、Googleがそのコンテンツをあまり必要としていないと判断して飛ばすことであり、コンテンツの品質の問題だと説明しています。なお、Mueller氏はこれもホストロードに関係すると述べており、Montti氏は「自分は同意できるかわからない、各自で判断してほしい」と書いています。
Mueller氏の発言の核心は次の部分です。
And the crawl demand is very often based on the perceived quality of a website.
日本語にすると「そしてクロールの需要は、非常に多くの場合、ウェブサイトの品質がどう受け止められているかに基づいている」という内容です。同氏は、それがサイトからどれだけクロールしインデックスするかに非常に大きな影響を与えうるとし、システムがサイト全体の品質をすばらしくないと見なせば、クロールやインデックスにあまり時間をかけず、今はサイトマップファイルにも手を付けない、と説明しました。
出典が3つ目の理由として紹介しているのは、Googleがそもそもサイトマップを必要としていない場合です。Mueller氏は、サイトの品質が時間をかけて大きく改善したと判断すればサイトマップファイルを使いに行くが、単に使いたくないだけのこともある、と述べています。
同氏は、これは純粋に技術的な問題ではなく、Google側が本当にそのサイトマップファイルを必要とし、欲しているかの問題でもある、と述べています。
出典が指摘するSearch Consoleの表示の問題
Montti氏は記事の最後で、Splitt氏もMueller氏も触れていないこととして、Search Consoleの大きな問題を指摘しています。表示されるメッセージ(couldn’t fetch)が実際の理由と一致していない、という点です。その結果、Search Consoleのユーザーは混乱し、不満を抱くことになると同氏は書いています。
さらに同氏は、Googleはこのメッセージが役に立たないことを明らかに分かっているのに、実質的に何もしていない、とも書いています。これは出典の筆者の論評であり、Googleが表示の変更について述べたという記述は出典にありません。
現場への意味(編集部の見解)
ここからは編集部の整理です。今回の話でいちばん実務に効くのは、「couldn’t fetch」という表示が、必ずしも技術的な取得失敗を意味しないとGoogleの担当者が語った点です。サイトマップのエラーを見ると、まずXMLの書式やサーバー設定を疑うのが普通です。もちろんその確認は必要ですが、形式が正しく、公開されていて、robots.txtからリンクされているなら、Splitt氏が挙げた条件はすでに満たしていることになります。その先で同じ設定を何度も見直しても、原因にたどり着けない可能性があります。
切り分けの順序としては、出典の内容に沿って次のように考えられます。
・まずサイトマップが有効か、公開されているか、robots.txtからリンクされているかを確かめる
・次にサーバーの負荷を疑う。Montti氏が書いているとおり、500エラーのレスポンスはSearch Consoleやサーバーのログファイルで確認できる
・どちらにも問題が無ければ、クロールの需要、つまりサイトの品質がどう受け止められているかという観点で見る
ここからは編集部の推測ですが、3つ目の段階に来たときは、サイトマップそのものをいじるより、サイト全体のコンテンツをどう改善するかに時間を使うほうが筋がよいと考えます。Mueller氏は、品質が時間をかけて大きく改善すればサイトマップファイルを使いに行くと述べており、サイトマップは品質の結果として読まれるもの、という位置づけに読めるからです。
また、報告の際に「couldn’t fetch」を「サーバー障害」や「設定ミス」と決めつけて伝えると、切り分けを誤らせます。表示だけでは理由を特定できない、という前提を共有しておくのが正確だと編集部は考えます。
まとめ
・Search Engine JournalのRoger Montti氏が2026年10月6日、GoogleのMartin Splitt氏とJohn Mueller氏がサイトマップの「couldn’t fetch」エラーについて話し合った内容を報じた
・Splitt氏は、有効で公開されておりrobots.txtからリンクされたXMLサイトマップでも、Search Consoleが取得できないと表示することがあると認めた
・Mueller氏は1つ目の理由として、サーバーのホストロードの問題や、ほかのことで忙しくサイトマップをクロールする時間が無い場合を挙げた
・2つ目の理由はクロールの需要で、Mueller氏はそれが非常に多くの場合ウェブサイトの品質がどう受け止められているかに基づくと述べた。3つ目として、Googleがサイトマップを必要としていない場合もあるとされる
・Montti氏は、表示されるメッセージが実際の理由と一致せず、ユーザーが混乱し不満を抱く点をSearch Consoleの大きな問題として指摘した。これは出典の筆者の論評である
よくある質問
Q1: サイトマップが有効なのに「couldn’t fetch」と出るのはなぜですか?
出典によると、Mueller氏はこのエラーに2つの理由があると説明しています。1つはサーバーのホストロードの問題で、Googleが本当にアクセスできない場合や、ほかのことで忙しくサイトマップをクロールする時間が無い場合です。もう1つはクロールの需要で、Googleのシステムがこのサイトから多くをクロールする必要が無いと判断すると、サイトマップファイルを飛ばすことがあるとされています。
Q2: サイトの品質はサイトマップの取得に関係するのですか?
Mueller氏は、クロールの需要は非常に多くの場合ウェブサイトの品質がどう受け止められているかに基づいており、それがどれだけクロールしインデックスするかに非常に大きな影響を与えうると述べています。サイト全体の品質がすばらしくないと見なされれば、今はサイトマップファイルにも手を付けないことがあり、品質が時間をかけて大きく改善すればサイトマップファイルを使いに行くとされています。
Q3: サーバー負荷が原因かどうかはどう確かめればよいですか?
出典の筆者であるMontti氏は、夜間に多数のクローラーがサイトに集中してサーバーが500エラーを返すことでもホストロードの問題は起きうるとし、500エラーのレスポンスはSearch Consoleで確認でき、アクセスできるならサーバーのログファイルでも確認できると書いています。これはMueller氏の発言ではなく、出典の筆者による補足です。
出典:Google Explains The “Couldn’t Fetch” Sitemap Errors(Search Engine Journal、Roger Montti氏、2026年10月6日)https://www.searchenginejournal.com/google-explains-couldnt-fetch-sitemap-errors/592040/
無料ダウンロード資料
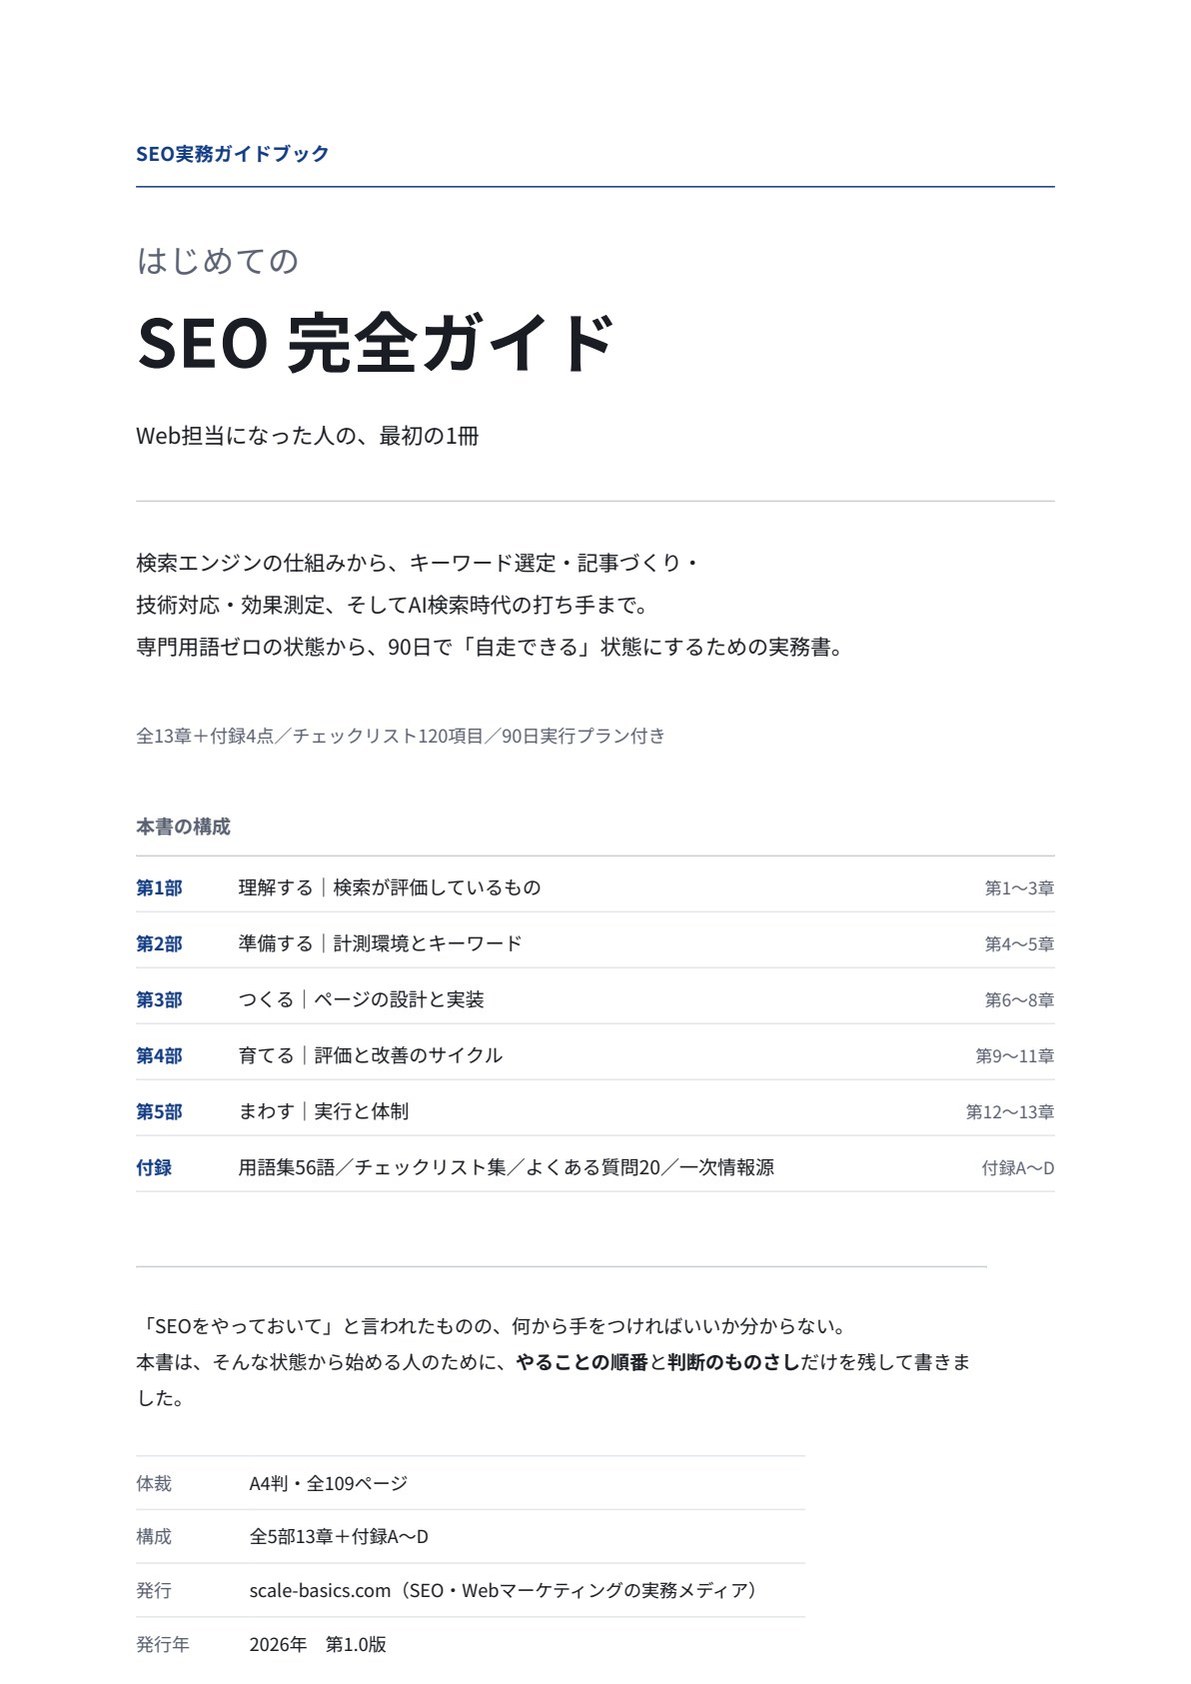
はじめてのSEO 完全ガイド
Web担当になった人が、90日で自走するための実務書
検索エンジンの仕組みから、キーワード選定・記事づくり・技術対応・効果測定、 そしてAI検索時代の打ち手まで。専門用語の知識ゼロの状態から読み始められるよう、用語はすべて本文中で説明しています。
| 体裁 | PDF/A4縦・全109ページ |
|---|---|
| 収録 | 図解21点、チェックリスト120項目、90日実行プラン、用語集56語 |
※フォーム送信後、ご入力のメールアドレス宛にダウンロードリンクをお送りいたします。
こちらのフォームにご記入ください
入力は1分ほどで終わります。