何が起きたか:GoogleがポッドキャストでPDFの処理と順位付けを解説
Search Engine Roundtableによれば、今回の回はPDFがクロールとインデックスのためにどう変換されるか、Googleがリンクや画像をどう処理するか、ファイルの上限はどうなっているか、PDFは検索やAI検索で順位が付くのか、といった論点を扱っています。チャプターは、llms.txtをPDFとして保存してよいかという話題から始まり、PDFとHTMLの違い、Googleのコンバーターの仕組み、画像とリンクの抽出、クロールの上限とファイルサイズ、PDFを公開すべき場面、検索とAI OverviewsとAI ModeでPDFは順位が付くか、ラスタライズされたページやスキャン画像の問題、モバイルでの表示、重複するPDFの正規化、メタデータとパスワード保護と更新、CMSによるPDFの自動生成、飲食店のメニューをPDFにするかHTMLにするか、そしてGEO(Generative Engine Optimization)とAIのグラウンディングまで並んでいます。
もっともSchwartz氏は、こうした内容の大半は同誌がすでに取り上げてきたもので、例外はGEOやAI検索の側面くらいだが、その点についてGoogleは多くを語らなかった、とも書いています。
PDFはHTMLに変換されてからインデックスされる
Search Engine Journalによれば、Splitt氏は、GoogleはPDFをコンバーターでHTMLに変換し、PDFそのものではなく変換後のHTMLをインデックスしていると説明しました。同氏の発言は次のとおりです。
we have a component called a converter. And the converter component is part of what happens in indexing. It happens right after rendering and right before something potentially makes it into the index.
日本語にすると「私たちにはコンバーターと呼ぶコンポーネントがある。コンバーターはインデックス処理の一部で、レンダリングの直後、何かがインデックスに入る可能性がある直前に行われる」という内容です。同氏は、リッチテキスト、ドキュメントファイル、Excelのシート、Lotus Notesの文書など、さまざまな形式向けのコンバーターがあり、PDFコンバーターもその一つだと述べています。HTML版を作ることで、パイプラインの残りの処理はほぼHTMLだけを扱えばよくなる、という説明です。画像や動画は少し異なるパイプラインに回るとも付け加えています。
この変換が、PDF内のリンクが機能する理由にもなっています。Mueller氏は、PDFを扱い慣れたウェブページのようなものに変換するからリンクも機能するのだろうと述べ、Splitt氏も、元の形式にできる限り忠実なHTMLの表現に変換するのでリンクなども見える、と応じました。
はっきりしないのが画像です。Splitt氏は、PDF内の画像を拾っている可能性はあるとしつつ、通常は画像のURLを画像検索のパイプラインに渡して処理しているところ、PDFの一部である画像にはURLが無いため、通常の画像のようには処理できないと思う、と述べました。ただし、それは変わるかもしれないし、すでに変わったかもしれない、あくまで自分の現時点の理解だ、とも断っています。
ファイルサイズの上限と再クロールの頻度
ファイルサイズについては、Mueller氏が、自分たちも細部を知らないことがあり、分かっていることから推測して説明しているのだと前置きしたうえで、PDFのサイズの上限について尋ねています。Splitt氏の答えは、PDFの取得には通常のウェブページとは異なる上限がおそらくあり、動画や画像と同じように大きな上限があると思う、というものでした。そして具体的な数字については次のように述べています。
But I don’t know the specific limit for PDF files.
日本語にすると「ただ、PDFファイルの具体的な上限は知らない」という内容です。同氏は、PDFを変換した後のウェブページの表現には通常のHTMLの上限が適用されるのだろう、とも述べています。またSearch Engine Journalによれば、上限は、より大きなPDFが公開されるようになれば将来変わりうるとも話しました。Schwartz氏のまとめによれば、PDFのクロールの上限は通常のHTMLページより大きく、ポッドキャストでは、ファイルサイズの標準が変わるにつれて上限が調整されるため、Googleは正確な上限を意図的に文書化していないと説明されました。ただしSchwartz氏はAlthough, Google does document that.と補足しています。日本語にすると「もっとも、Googleはそれを文書化している」という内容です。同誌の過去記事の一覧にも「Googlebot File Limit Is 15MB But 64MB For PDF & 2MB For Other File Types」という見出しがあり、PDFは64MBとされています。今回の回で、Splitt氏自身が口頭で具体的な数字を示したわけではありません。
再クロールの頻度も、実務に響く論点です。Schwartz氏のまとめによれば、GoogleはPDFを画像に近い比較的静的なバイナリファイルとして扱い、HTMLよりかなり低い頻度でしか再クロールしません。そのため、更新したPDFを早くインデックスさせたい場合は、既存のファイルを上書きするのではなく、新しいURLやファイル名で公開すべきだとしています。
検索とAI Overviews・AI Modeでの扱い
Search Engine Journalによれば、Splitt氏は、PDFは通常の検索で順位が付くのと同じ理由でAI Modeでも順位が付きうると認めました。HTMLに変換してからインデックスするからです。PDFを作るべきかという問いに対しては、内容がそれを必要とするなら作ってよい、たとえば特定の書式の要件がある場合、印刷で見た目を厳密にそろえたい場合、フォームのような対話的な要素が必要な場合だ、と答えています。飲食店が印刷用のメニューのPDFをサイトに上げる例も挙げ、メニューが全く無いよりはよいとしました。そのうえで次のように述べています。
…indexing and ranking is pretty much the same as any other document.
日本語にすると「インデックスと順位付けは、他のどの文書ともほぼ同じだ」という内容です。これを受けてMueller氏はSo they can also appear in AI overviews, AI mode, all of those things.と加えました。日本語にすると「だからAI OverviewsやAI Modeなど、そうしたすべてにも表示されうる」という内容です。Schwartz氏のまとめは、さらにAIモデルの学習やグラウンディングにも使われうる、としています。
ただし、どのPDFでも本文で順位が付くわけではありません。Splitt氏は、画像のようなPDFがあると指摘し、PDFの文字を選択してテキストファイルにコピーできれば、Googleは順位付けのためにHTMLへ変換できるだろう、という確認方法を示しました。Mueller氏も同じ確認方法に触れています。Schwartz氏も、スキャン画像やラスタライズされたページはOCRが無ければ読めないと整理しています。
そのうえでMueller氏は、PDFかHTMLかを選べるならHTMLを好むという立場も示しました。メニューをPDFにするか全く置かないかならメニューがあるほうがよいが、PDFと通常のウェブページの比較なら、操作しやすい通常のウェブページのほうが好きだ、という趣旨です。さらに、PDFと同じ内容をHTMLにできるならそのほうが全体が少し楽になる、とも述べています。
Search Engine Roundtableが整理した運用上の注意点
Schwartz氏は、ポッドキャストを2回聴き、書き起こしも読んだうえで、要点を次のようにまとめています。以下は同氏のまとめであり、Googleの公式文書ではありません。
・モバイルとアクセシビリティ:PDFはモバイル端末で表示する前に全体をダウンロードする必要があり、印刷用の固定レイアウトのため拡大しても文字が折り返されない。アクセシブルな構造になっていなければ、スクリーンリーダーの妨げにもなりうる
・正規化と重複:同一のPDFはバイナリとして完全な重複になるため、ドメインをまたいだ正規化が難しい。rel=canonicalのHTTPヘッダー、PDFのメタデータ欄の記入、文書の冒頭に自サイトへのリンクを目立つ形で置くことで、重複の問題を和らげられる
・アクセス制限:パスワード保護をかけると、検索エンジンのボットはPDFの内容を読むこともインデックスすることもできない
・印刷用PDFの自動生成:公開中のウェブページのPDF版をCMSのツールで自動生成すると、両方が検索結果で競合し、再クロールの頻度が低いPDF版のほうは古いまま残りうる
・llms.txt:機械が読むためのファイルであるllms.txtは、シンプルで軽いプレーンテキストを提供することが目的なので、PDFにすべきではない
同氏の推奨は、既定はHTMLにし、PDFは印刷用の厳密な書式、オフラインで使うフォーム、紙の資料が必要な場合に選択的に使う、というものです。
現場への意味(編集部の見解)
ここからは編集部の整理です。Schwartz氏が、内容の大半は同誌がすでに取り上げてきたものだと書いているとおり、今回の回は新しい仕様の発表というより、GoogleがPDFの扱いをまとめて説明し直したものと受け止めるのが妥当だと考えます。そのうえで、今回の話は「PDFは不利」でも「PDFでも問題ない」でもなく、変換後のHTMLとして読めるかどうかが分かれ目だと見るのが実務的だと考えます。Splitt氏とMueller氏が共通して挙げた確認方法は、PDFの文字を選択してテキストエディターに貼り付けてみることでした。社内に資料PDFが多いサイトでは、公開中のPDFをこの方法で一通り確かめ、スキャン画像だけでできているものを洗い出すのが最初の一手になります。
次に、更新の運用です。Schwartz氏のまとめどおりPDFの再クロール頻度が低いのであれば、料金表や仕様書のように内容が頻繁に変わる文書をPDFだけで公開し、同じファイル名で上書きしていく運用は、検索結果に古い内容が残る原因になりえます。こうした文書は本体をHTMLにし、PDFは印刷用の補助として置くほうが扱いやすいはずです。どうしてもPDFを差し替える場合は、新しいファイル名で公開するという同氏の整理が参考になります。
AI検索との関係では、Mueller氏がPDFもAI OverviewsやAI Modeに表示されうると述べた点は押さえておく価値があります。ただしSchwartz氏が書いているとおり、GEOやAI検索の側面についてGoogleは多くを語っておらず、PDFだから有利、不利といった材料は今回出ていません。AI検索への備えを考える際は、AI Overviews対策の基本と同じく、まずインデックスされる形で内容を出しておくことが前提になると考えます。
最後にサイズの上限です。ポッドキャストでSplitt氏は具体的な数字を口頭では示しませんでしたが、Schwartz氏はGoogleがそれを文書化していると補足し、同誌の過去記事の見出しにはPDFは64MBとあります。上限の数字を社内資料に載せる場合は、ポッドキャストの発言ではなく、この文書化された記述を出典として確認しておくのが確実だと考えます。また上限の範囲内であっても、巨大なPDFは分割やHTML化を検討する余地があると考えます。
まとめ
・GoogleのMartin Splitt氏とJohn Mueller氏が、Search Off the RecordのポッドキャストでPDFの扱いを解説した回を公開したと、Search Engine Roundtableが2026年10月13日に、Search Engine Journalが10月14日に伝えた
・Splitt氏によれば、GoogleはインデックスのパイプラインにあるコンバーターでPDFをHTMLに変換し、変換後のHTMLをインデックスする。そのためPDF内のリンクも通常のリンクと同じように扱われる
・PDF内の画像は単独のURLを持たないため、通常の画像のようには画像検索で処理できないというのがSplitt氏の現時点の理解で、同氏はそれが変わる可能性にも触れた
・PDFのファイルサイズの上限は通常のHTMLより大きいとみられ、Splitt氏は具体的な上限を知らないと述べた。ただしSchwartz氏はGoogleが上限を文書化していると補足し、同誌の過去記事の見出しにはPDFは64MBとある
・Splitt氏はPDFのインデックスと順位付けは他の文書とほぼ同じだとし、Mueller氏はAI OverviewsやAI Modeにも表示されうると述べた。ただしSplitt氏によれば、文字を選択してコピーできないPDFは本文で順位が付かない可能性がある
・Mueller氏はPDFと同じ内容をHTMLにできるならそのほうが楽になるとし、Schwartz氏も既定はHTML、PDFは選択的に使うべきだとまとめている
よくある質問
Q1: GoogleはPDFをそのままインデックスしているのですか?
Search Engine Journalによれば、Martin Splitt氏は、GoogleはPDFビューアーを使うのではなく、インデックス処理の一部であるコンバーターでPDFをHTMLに変換し、その変換結果をインデックスしていると説明しました。この処理はレンダリングの直後、インデックスに入る可能性がある直前に行われるとしています。そのためPDF内のリンクも通常のウェブページのリンクと同じように扱われます。
Q2: PDFでもAI OverviewsやAI Modeに表示されますか?
John Mueller氏は、PDFもAI OverviewsやAI Modeなどに表示されうると述べました。Martin Splitt氏も、PDFはHTMLに変換してからインデックスするため、通常の検索と同じ理由でAI Modeでも順位が付きうるとしています。ただしSplitt氏によれば、スキャン画像のように文字を選択してコピーできないPDFは、本文の内容では順位が付かない可能性があります。テキストエディターに貼り付けて文字が取れるかどうかが確認方法として示されています。
Q3: PDFのファイルサイズに上限はありますか?
Martin Splitt氏は、PDFの取得には通常のウェブページより大きな上限があると思うとしつつ、PDFの具体的な上限は知らないと述べました。変換後のHTMLの表現には通常のHTMLの上限が適用されるだろうとも話しています。Search Engine Roundtableによれば、ポッドキャストでは正確な上限は文書化していないと説明されました。ただしSchwartz氏は、もっともGoogleはそれを文書化している、と補足しており、同誌の過去記事の見出しにはPDFは64MBとあります。
出典:Google Search On PDFs: Conversion, Links, HTML, Ranking, Limits, Crawling…(Search Engine Roundtable、Barry Schwartz氏、2026年10月13日)https://www.seroundtable.com/google-search-on-pdfs-42291.html
出典:Google Explains How They Rank PDFs And What It Means For SEO/GEO(Search Engine Journal、Roger Montti氏、2026年10月14日)https://www.searchenginejournal.com/google-explains-how-they-rank-pdfs-and-what-it-means-for-seo-geo/592902/
無料ダウンロード資料
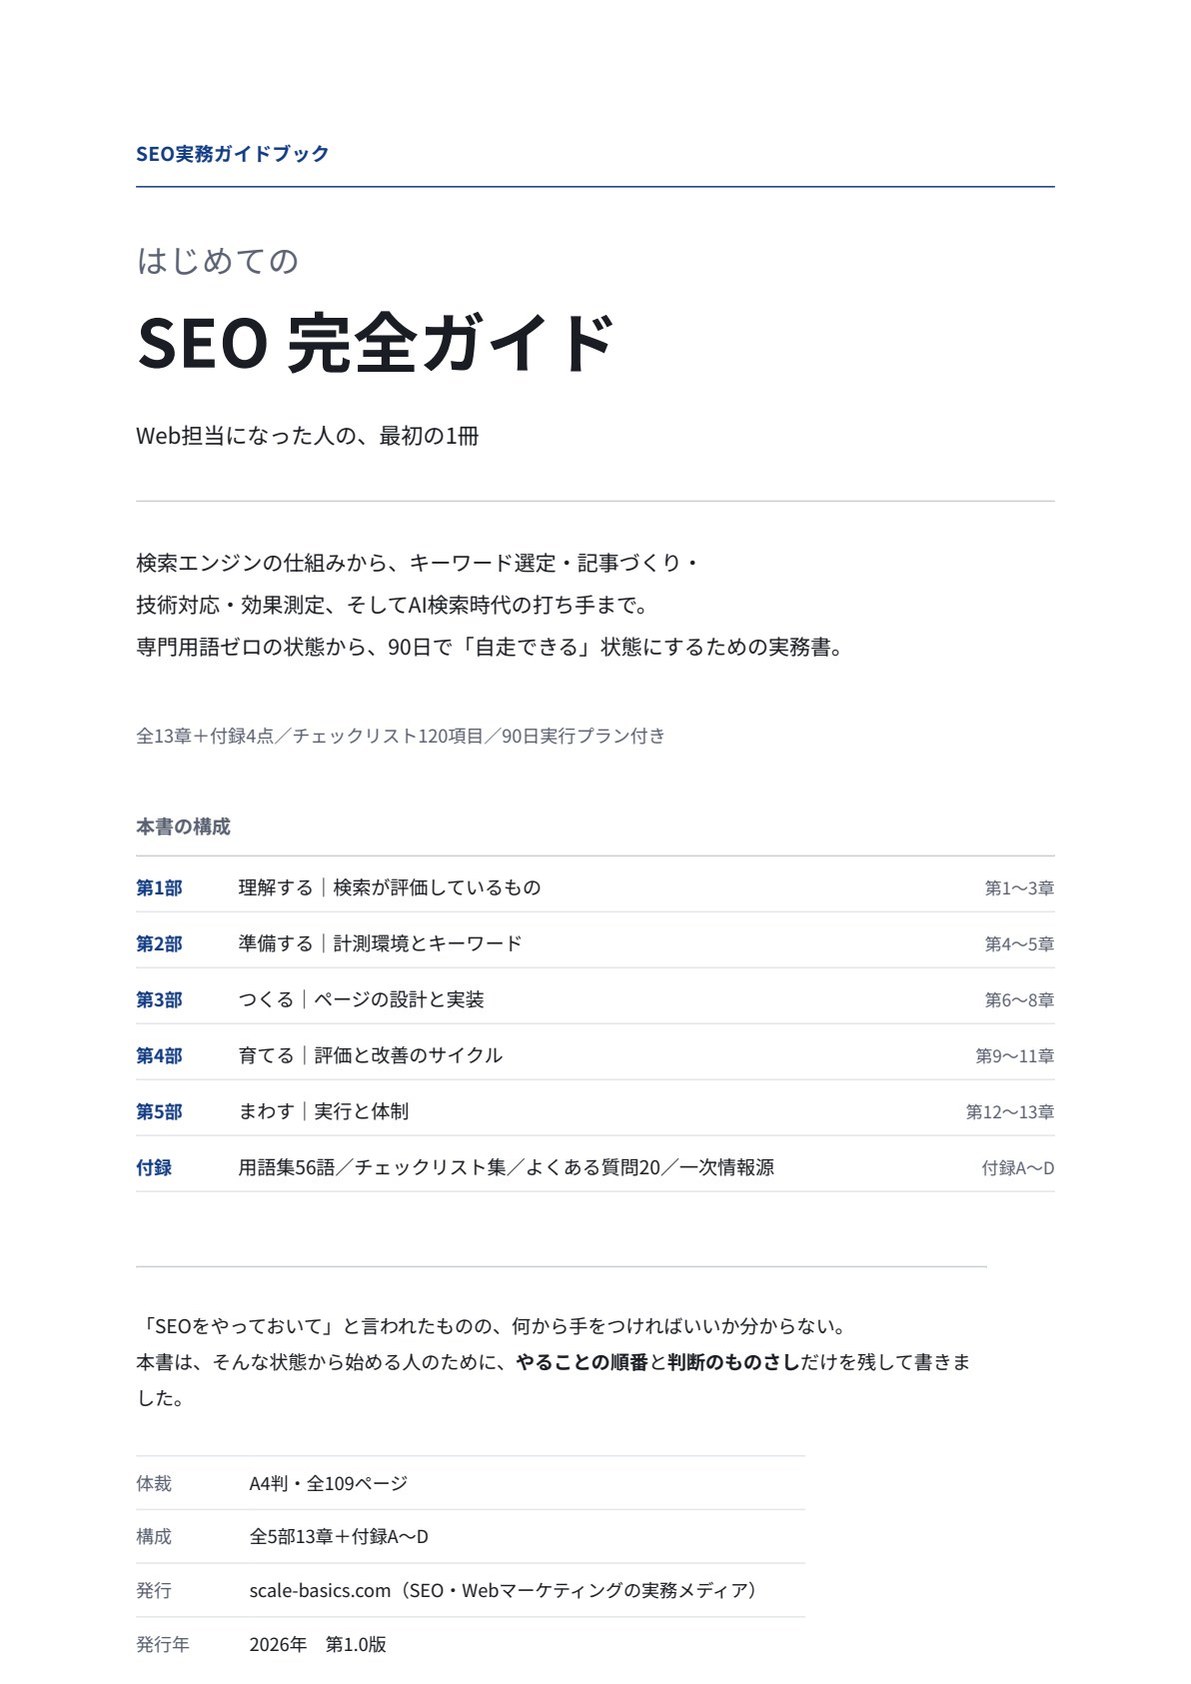
はじめてのSEO 完全ガイド
Web担当になった人が、90日で自走するための実務書
検索エンジンの仕組みから、キーワード選定・記事づくり・技術対応・効果測定、 そしてAI検索時代の打ち手まで。専門用語の知識ゼロの状態から読み始められるよう、用語はすべて本文中で説明しています。
| 体裁 | PDF/A4縦・全109ページ |
|---|---|
| 収録 | 図解21点、チェックリスト120項目、90日実行プラン、用語集56語 |
※フォーム送信後、ご入力のメールアドレス宛にダウンロードリンクをお送りいたします。
こちらのフォームにご記入ください
入力は1分ほどで終わります。