前提:LLM向けMarkdownファイルとは何か
Search Engine Journalの説明によれば、Markdownファイルは機械にも人間にも読める形式のコンテンツで、あるものが見出しであるかどうかなどを示すマークアップを含みます。本質的には、インタラクティブな要素をすべて取り除いたコンテンツであり、JavaScriptもCSSもありません。
この形式をLLMに提供する狙いは、人間向けの操作のために存在する余計なHTMLやJavaScriptなどを処理しなくても、LLMがコンテンツを取り込めるようにすることにあります。
そしてLLMにMarkdownファイルを配信する動機は、AI検索の面でのランキングにおいて優位を得ることだ、と同記事は書いています。ここが今回の論点の出発点です。
Redditでの質問:大手AIボットが実際にMarkdownを要求した例はあるか
議論を始めた質問者の投稿は、次の内容でした。
すでにHTMLのウェブページをキャッシュしているので、それをMarkdownに変換して再度キャッシュし、ボットがMarkdownを求めているかどうかヘッダーを確認することは、それほど大きな手間ではない。オンラインで見つけられる情報はすべて読んだが、大勢としては、AIによる引用を増やすことには役立たないが害もない、というものらしい。
そのうえで質問者は、純粋にAIボットが自分のサイトを叩きまくるのを止める目的だけでも、やる価値があるかどうかを知りたいと述べています。数体のボットは暴走していたためCloudflareでブロックせざるを得なかったが、より小さいMarkdownファイルを要求してくるのであれば、再び通す価値があるかもしれない、という文脈です。ファイルはおよそ3分の1のサイズまで削れる、とも書かれています。
そして質問の核心は次の一文でした。大手AIボットのいずれかが実際にMarkdownを要求するのを見た人はいるか、というものです。
Mueller氏の回答:名乗ったのはSEOツールだけ
この問いに対し、GoogleのJohn Mueller氏は自身の経験を共有しました。同氏の投稿は次のとおりです。
On my test sites the only crawlers who claim to accept markdown are SEO tools. Ymmv.
日本語にすると「私のテストサイトでは、Markdownを受け付けると表明しているクローラーはSEOツールだけだ。結果は環境により異なる」という内容です。
続けて同氏は、計測そのものの難しさにも触れています。
(Also, it's annoying that the server setups that I use don't log the accept header, so you have to manually set things up for logging even if you just want to see if anyone would accept it. If you're curious about your sites, I'd recommend figuring out how to log that and checking the metrics first.)
日本語にすると「(また、私が使っているサーバー構成はacceptヘッダーをログに記録しないので厄介だ。誰かが受け付けるかどうかを見たいだけであっても、ログ記録を手動で設定する必要がある。自分のサイトについて気になるなら、それをログに残す方法を調べて、まず数値を確認することを勧める)」という内容になります。
この後半部分は見落とされがちですが、実務上はここがもっとも具体的な助言です。Markdownを用意するかどうかを議論する前に、そもそも自社サイトに対してMarkdownを受け付けると表明するリクエストが来ているのかを、acceptヘッダーのログで確認せよ、という順序が示されています。
Search Engine Journalの評価:キーワードメタタグとの類似
Search Engine Journalは、LLM向けMarkdownファイルの問題点を、過去のキーワードメタタグになぞらえて論じています。
同記事の指摘は次の点です。生成検索とLLMの各社は、HTMLファイルのクロールとインデックスをすでに完全に習得しています。さらに各社にとっては、LLM専用に作られた特別なコンテンツではなく、利用者が実際に目にするものをダウンロードすることが自社の利益にかないます。
その理由として挙げられているのが、LLM専用のコンテンツについてはサイト運営者やSEO担当者を信頼できない、という点です。同記事は、これがキーワードメタタグが失敗した理由でもあると書いています。誰もがキーワードのバリエーションやスペルミス、コンテンツに登場しないフレーズを詰め込んだためです。
結論として同記事は、Markdownファイルを取り込むことにLLMやAIエージェント側の利点はないと述べています。信頼できないうえに、HTMLコンテンツのダウンロードとインデックスは些細な作業であり、原文の表現を借りれば well over thirty years、ゆうに三十年を超える期間にわたって解かれてきた問題だからです。
対照的な見方:CloudflareのMarkdown配信
一方で、異なる立場も紹介されています。Search Engine Journalによれば、CloudflareはMarkdownファイルがLLMのあいだで非常に人気があるという考えを持っており、それを求めるAIエージェントにMarkdownファイルを提供できるサービスを提供しています。
同社の記述として引用されているのは次の内容です。
Markdown has quickly become the lingua franca for agents and AI systems as a whole. The format's explicit structure makes it ideal for AI processing, ultimately resulting in better results while minimizing token waste.
日本語にすると「Markdownは急速に、エージェントおよびAIシステム全体にとっての共通語になった。この形式の明示的な構造はAIの処理にとって理想的であり、結果としてトークンの無駄を最小化しながらより良い結果をもたらす」という内容です。
技術的な提供方法についても説明があります。Cloudflareのネットワークは、content negotiationのヘッダーを使う有効化されたゾーンについて、ソースでのリアルタイムのコンテンツ変換に対応しています。Cloudflareを使いMarkdown for Agentsを有効にしているサイトへAIシステムがページを要求する際、リクエストでtext/markdownを希望として示せば、同社のネットワークが可能な場合に自動かつ効率的にHTMLをMarkdownへ変換する、という仕組みです。
これに対するSearch Engine Journalの評価は率直です。同記事は、正直なところそれは現実ではない、もしそうであればあのRedditの議論はMarkdownファイルの成功事例で埋まっていたはずだ、と書き、CloudflareによるAIエージェントの需要の描き方は過度に楽観的だと評しています。
Markdownが実際に有用な領域:AIエージェントへの指示
Search Engine Journalは、Markdownが役に立たないと言っているわけではありません。有用な領域が別にある、という整理をしています。
同記事によれば、OpenAIとAnthropicはMarkdownファイルについてより現実的で、それはAIエージェントのスキル、ガイダンス、指示にとっての共通語だからです。
例として引用されているのはOpenAIのサポートページの記述です。
Custom instructions with AGENTS.md
説明では、プロジェクト向けにCodexへ追加の指示と文脈を与えるものとされ、CodexはいかなるWorkに取りかかる前にもAGENTS.mdファイルを読む、と書かれています。全体的なガイダンスにプロジェクト固有の上書きを重ねることで、どのリポジトリを開いても一貫した前提で各タスクを開始できる、という位置づけです。
つまりMarkdownは、AIエージェントへの指示や文脈の受け渡しという用途ではすでに標準的に使われています。同記事の整理では、その有用性はクロール、インデックス、AI検索エンジンでのランキングにおける優位にはつながらない、という線引きになります。
Search Engine Journalが挙げた要点
同記事は、記事の要点を次のように整理しています。
・ウェブページのMarkdown版を配信することが、AIによる引用やAI検索での可視性を向上させるという証拠はここには無い
・GoogleのJohn Mueller氏は、自身のテストサイトでMarkdownファイルを覗きに来たクローラーはSEOツールだけだったと述べている
・Mueller氏の助言は、ボット向けにMarkdownの生成へ全面的に踏み切る前に、AIボットが実際にMarkdownを要求しているかどうかを追跡する仕組みを整えること
・すべてのAIシステムはすでにHTMLをクロールしインデックスできる。各社の側に、HTMLページとは別のMarkdown版を必要とする理由はない
・Cloudflareは、AIシステムが要求した際にHTMLからMarkdownへ自動変換することに対応している。ただしAIエージェントの需要に関する同社の描写は過度に楽観的である
・MarkdownはAIエージェントへの指示と文脈のためにすでに有用であり、OpenAIのCodexによるAGENTS.mdの利用や、Anthropic Claudeにおける利用が含まれる
・AIエージェントにとってのMarkdownの有用性は、AI検索エンジンでのクロール、インデックス、ランキングにおける優位にまでは及ばない
実務でどう扱うか(編集部の見解)
ここからは、報道内容を踏まえた編集部の判断です。
まず、Mueller氏の助言の順序をそのまま採用するのが合理的だと考えます。Markdown版を用意するかどうかを検討する前に、acceptヘッダーをログに記録し、自社サイトに対して実際にMarkdownを希望するリクエストが来ているかを確認する。この確認を先に済ませれば、判断材料が推測ではなく自社の実測値になります。同氏自身が、使っているサーバー構成ではacceptヘッダーが記録されないため手動での設定が必要だと述べており、この作業が自動では済まない点も含めて現実的な助言になっています。
次に、Redditの質問者が挙げていた動機の区別は有効だと考えます。同氏の関心は、AI引用を増やすことではなく、暴走するボットの負荷を軽くすることにありました。ファイルを3分の1程度まで削れるという見立てが正しければ、これは可視性の施策ではなく帯域とサーバー負荷の施策です。目的が違えば評価すべき指標も違います。可視性の向上を期待して導入し、効果が出ないと結論づける前に、そもそも何のために入れるのかを決めておく必要があります。
最後に、Markdownの用途を分けて考えることを勧めます。AIエージェントへの指示という用途では、AGENTS.mdの例が示すとおりすでに定着しています。一方、検索での可視性を上げる手段としては、今回の報道の範囲では裏づけとなる証拠が示されていません。同じ形式が使われているという理由だけで、両者の有効性を混ぜて語らないほうが、社内の意思決定は正確になります。
まとめ
・RedditでLLM向けMarkdownファイルの成果について質問が出され、GoogleのJohn Mueller氏が自身のテストサイトでの経験を共有した。Markdownを受け付けると表明したクローラーはSEOツールだけだったという内容
・Mueller氏は、使用しているサーバー構成がacceptヘッダーをログに残さないため手動設定が必要だと述べ、自分のサイトが気になるならログの取り方を調べてまず数値を確認するよう勧めている
・Search Engine Journalは、LLM専用コンテンツはキーワードメタタグと同じ理由で信頼されないと指摘。各社はHTMLのクロールとインデックスをすでに習得しており、利用者が実際に見るものを取得するほうが各社の利益にかなうと論じている
・Cloudflareは、Markdownがエージェントの共通語になったとして、Markdown for Agentsを有効にしたゾーンでHTMLからMarkdownへのリアルタイム変換に対応している。ただし同記事はこの需要の描写を過度に楽観的だと評している
・MarkdownはAIエージェントへの指示と文脈という用途では有用で、OpenAIのCodexがAGENTS.mdを読む例が挙げられている。ただしその有用性は、AI検索でのクロール・インデックス・ランキングの優位には及ばないとされる
よくある質問
Q1: Markdown版のページを用意すると、AI検索での引用は増えますか?
Search Engine Journalは、ウェブページのMarkdown版を配信することがAIによる引用やAI検索での可視性を向上させるという証拠はここには無い、と要点で明記しています。同記事は、すべてのAIシステムがすでにHTMLをクロールしインデックスでき、各社の側にHTMLとは別のMarkdown版を必要とする理由はないと論じています。またLLM専用のコンテンツは、かつてキーワードメタタグが詰め込みによって失敗したのと同じ理由で信頼されにくい、という指摘もなされています。
Q2: 導入を検討する場合、最初に何をすべきですか?
GoogleのJohn Mueller氏は、acceptヘッダーをログに記録して、まず数値を確認することを勧めています。同氏は、自身が使っているサーバー構成ではacceptヘッダーが記録されないため、誰かが受け付けるかどうかを見たいだけでも手動でログ記録を設定する必要があると述べています。自分のサイトについて気になるなら、その記録方法を調べたうえで指標を先に確認するように、というのが同氏の助言です。
Q3: MarkdownはAI関連で全く役に立たないということですか?
いいえ。Search Engine Journalは、MarkdownがAIエージェントのスキル、ガイダンス、指示にとっての共通語であり、この用途ではすでに有用だと整理しています。例としてOpenAIのCodexがAGENTS.mdファイルを作業前に読む仕組みや、Anthropic Claudeにおける利用が挙げられています。同記事の線引きは、その有用性がクロール、インデックス、AI検索エンジンでのランキングにおける優位にまでは及ばない、というものです。
出典:Google’s Mueller Shares Their Experience With Markdown For AI SEO(Search Engine Journal、Roger Montti氏、2026年8月31日)https://www.searchenginejournal.com/googles-mueller-shares-their-experience-with-markdown-for-ai-seo/587671/
無料ダウンロード資料
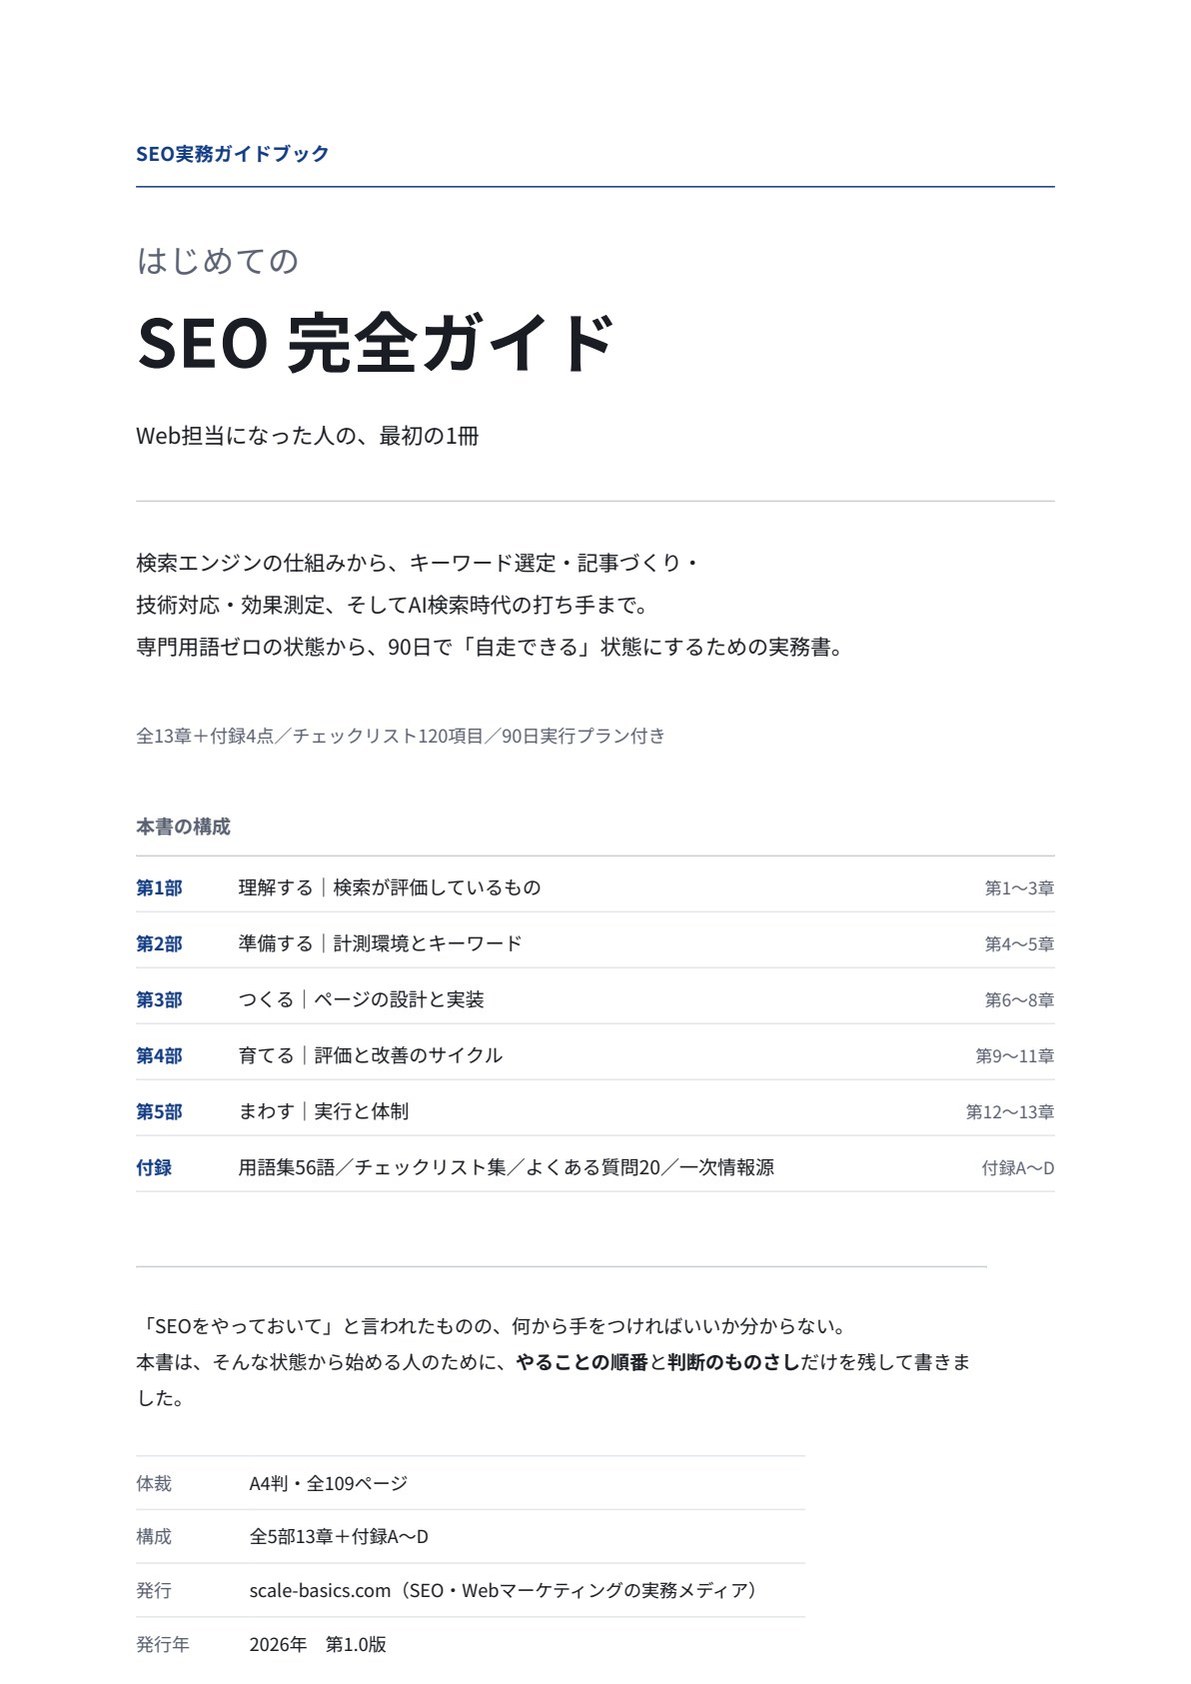
はじめてのSEO 完全ガイド
Web担当になった人が、90日で自走するための実務書
検索エンジンの仕組みから、キーワード選定・記事づくり・技術対応・効果測定、 そしてAI検索時代の打ち手まで。専門用語の知識ゼロの状態から読み始められるよう、用語はすべて本文中で説明しています。
| 体裁 | PDF/A4縦・全109ページ |
|---|---|
| 収録 | 図解21点、チェックリスト120項目、90日実行プラン、用語集56語 |
※フォーム送信後、ご入力のメールアドレス宛にダウンロードリンクをお送りいたします。
こちらのフォームにご記入ください
入力は1分ほどで終わります。