何が起きたか:SEO研究者が「冗談の標準」cats.txtで実験を実施
Search Engine Journalに掲載された記事「How Cats.txt Showed LLMs.txt Evidence Is GEO Astrology」で、著者のMark Williams-Cook氏(SEO専門企業Candourのディレクター)は、自ら考案した冗談の仕様ファイル「cats.txt」を使った実験を紹介しています。cats.txtは、robots.txtやllms.txtと同じようにドメインのルートに置くテキストファイルで、サイトに関連付けた猫の名前、役職(job title)、品種、そして「PurrLevel」と呼ばれる10点満点の愛情指標を記載する、という架空の仕様です。
Williams-Cook氏はこの仕様を自身のブログ(markwilliamscook.com)に正式な仕様書として公開し、LinkedInでも紹介しました。狙いは、llms.txtの効果を裏付けるものとして業界内で繰り返し挙げられてきた「4つの証拠」を、この冗談ファイルにも同じ基準で当てはめたとき、cats.txtが”合格”してしまうかどうかを検証することでした。
実験の詳細:llms.txt支持の根拠とされる「4つの証拠」を同じ基準で検証
記事によると、Williams-Cook氏が検証した4つの”証拠”と、cats.txtでの結果は次のとおりです。
1つ目は「クローラーによる取得」です。PerplexityBot、GPTBot、ClaudeBot、Googlebotなど複数のボットがcats.txtファイルを実際にフェッチ(取得)したことが確認されています。同氏はこれについて「フェッチすることはクローラーの職務内容そのものだ(Fetching things is the entire job description of a crawler.)」と述べ、ファイルが取得されたという事実だけでは何の証拠にもならないと指摘しています。
2つ目は「Googleによるインデックス」です。cats.txtはGoogleにインデックスされ、Search Consoleでも追跡可能になったといいます。
3つ目は「LLMがファイル内の情報をそのまま返す」ことです。実験に参加したDave Smart氏のサイト(tamethebots.com)に記載した猫「Odd」について、Google AIの概要(AI Overview)が「Render Cat, a Tuxedo with a PurrLevel of 5/7, who chases the cursor(レンダー猫、タキシード柄でPurrLevelは5/7、カーソルを追いかける)」という、cats.txtにしか存在しない情報をそのまま表示したと報告されています。
4つ目は「ChatGPTによる肯定的な回答」です。ChatGPTに「cats.txtはランキングに役立つか」と尋ねると、「Yes — cats.txt can potentially help you rank in both search engines and LLM-driven systems(はい、cats.txtは検索エンジンとLLM主導のシステムの両方で、あなたのランキングを助ける可能性があります)」という回答が返ってきたとされています。
著者が指摘する核心:「もっともらしい」ことと「効果がある」ことは別物
Williams-Cook氏は、llms.txt自体を否定しているわけではないと明言しています。記事では「私はllms.txtが決して機能しないと主張しているのではない。それが論点ではない(I am not claiming llms.txt will never work. This is not the point.)」と述べており、問題視しているのはllms.txtの効果そのものではなく、その効果を裏付けるとして提示されてきた”証拠”の質だとしています。
同氏の主張の核心は、大規模言語モデルは推論しているわけではないという点にあります。記事は「それは推論ではない。実験を行っているのでも、情報源を確認しているのでも、証拠を比較検討しているのでもない(It is not reasoning. It is not running an experiment, consulting a source, or weighing evidence.)」と説明し、モデルは単に「最もよく言われていること」、つまりインターネット上の通説を返しているに過ぎないとしています。ChatGPTがcats.txtについて「ランキングに役立つ」と答えたのも、cats.txtという架空のファイルを実際に検証した結果ではなく、llms.txtのような”◯◯.txtファイル”に関するインターネット上の一般的な言説を反映して返答しただけである可能性が高い、という理屈です。
この整理に沿うと、4つの”証拠”はそれぞれ次のように読み替えられます。ボットによる取得は、その内容が読まれ、信頼され、何らかの判断に使われたことを意味しません。Googleによるインデックスは、そのURLが存在し単語を含んでいるという事実の記録であって、重要性の評決ではありません。LLMが情報をそのまま返すのは、検索拡張生成(RAG)の通常の動作であり、そのファイルが特別に信頼されたソースであることの証明にはなりません。そしてLLMが「役立つ」と回答すること自体は、それが実際に役立つことの証拠ではなく、インターネット上にそう述べるテキストが多く存在することの証拠に過ぎません。
背景:llms.txtの効果をめぐる既存の懐疑論
記事は、llms.txtの効果に対してすでに存在していた懐疑的な見方も紹介しています。OpenAI・Anthropic・Googleといった主要な大規模言語モデルの提供企業は、いずれもllms.txtの利用を公式に文書化していないとされています。またAhrefsが実施した調査では、10万ドメイン(100,000 domains)を対象にllms.txtファイルの状況を分析した結果、多くのファイルが実質的に無視されており、測定可能な引用上の利点は確認できなかったと報告されています。
GoogleのJohn Mueller氏もBlueskyへの投稿で、llms.txtについて「率直に言って、現時点でllms.txtを使用しているAIシステムは存在しない。サーバーログを見れば一目瞭然だ(FWIW no AI system currently uses llms.txt, […] It’s super-obvious if you look at your server logs.)」と述べたことが記事内で引用されています。
なぜ重要か:GEO施策のエビデンス検証で疑うべきこと
今回の実験が実務者に投げかけているのは、llms.txtという個別施策の是非にとどまらず、GEO(Generative Engine Optimization、生成エンジン最適化)施策全般の効果を「何をもって証明済みとするか」という基準の問題です。「クロールされた」「インデックスされた」「AIが言及した」「AIに聞いたら”役立つ”と答えた」という4種類の現象は、いずれもそれ単体では施策の効果を証明する根拠にならないと記事は論じています。
記事は最後に「llms.txtや、次のGEOの”儀式”、そのまた次の儀式の実装に費やす1時間、1ドルはすべて、実際に価値があると分かっている何かに使われなかった1時間、1ドルである(Every hour, and every dollar spent implementing llms.txt, or the next GEO ritual, or the one after that, is an hour and a dollar not spent on something you actually know has value.)」と結論づけており、根拠の検証を経ないままGEO関連の施策に工数を割くことへの警鐘を鳴らしています。
今日からできる確認手順
自社のGEO施策やllms.txt導入の検討にあたっては、次の点を確認しておくと、今回指摘された落とし穴を避けやすくなります。
1点目は、「クロールされた」「インデックスされた」「LLMが言及した」という現象と、「引用が増えた」「AI経由の流入が増えた」「問い合わせやコンバージョンが増えた」という効果を、社内の報告や資料の中で明確に分けて記録することです。前者はサーバーログやSearch Consoleで確認できる事実にすぎず、後者とは別物として扱う必要があります。
2点目は、ChatGPTなどのチャットボットに自社の施策について「効果があるか」と直接尋ねた回答を、施策の効果を裏付ける証拠として社内資料や提案書に使わないことです。モデルの回答はインターネット上の一般的な言説を反映しているに過ぎない可能性があります。
3点目は、llms.txtのようなファイルを導入する場合でも、導入前後でのAI経由の流入や言及状況を、期間比較や対照ページとの比較といった形で継続的に記録し、単発の”うまくいった事例”だけで効果を判断しないことです。
4点目は、Ahrefsによる10万ドメイン規模の調査のような第三者の大規模データも踏まえたうえで、llms.txtへの投資判断を、構造化データの整備やE-E-A-Tを高めるコンテンツ改善など、効果が確認されている他の施策とのコスト対効果で比較することです。
所感
運営者としては、今回のcats.txt実験は、GEO施策に限らずSEO全般の意思決定にも通じる教訓を含んでいると捉えています。「クロールされた」「インデックスされた」「AIに褒められた」といった観測結果は、それ自体は事実であっても、施策の効果を証明するものではありません。特にGEOのように評価指標がまだ確立されていない領域では、断片的な”うまくいった”事例が独り歩きしやすいため、実務者側が意識的に検証の基準を高く保つ必要があります。
llms.txtの導入自体は、robots.txtと同様に低コストで実施できる施策であり、置くこと自体を否定する材料ではありません。ただし、社内で「llms.txtを置いたから効果がある」という説明をする際は、今回の記事が示した4つの”証拠”の弱さを踏まえ、効果測定の設計(比較対象・期間・指標)をあわせて示せるようにしておくことをおすすめします。
まとめ
・Search Engine Journalの記事で、著者のMark Williams-Cook氏が、冗談の仕様ファイル「cats.txt」を使い、llms.txtの効果を裏付けるとされてきた4つの”証拠”を検証した
・cats.txtは、クローラーによる取得、Googleによるインデックス、LLMによる情報の返出、ChatGPTによる肯定的な回答という4つの証拠すべてに、llms.txtと同じ基準で”合格”した
・記事は、大規模言語モデルは推論しているのではなく「最もよく言われていること」を返しているに過ぎないとし、これらの現象は施策の効果を証明する根拠にならないと論じている
・Ahrefsによる10万ドメイン調査やGoogleのJohn Mueller氏の発言など、llms.txtの効果に対する既存の懐疑的な見方もあわせて紹介されている
・実務者は、施策の”観測結果”と”効果”を区別し、AIへの質問への回答を根拠として扱わないなど、GEO施策のエビデンス検証の基準を見直す必要がある
よくある質問
Q1: cats.txtとは何ですか?
SEO専門企業Candourのディレクター、Mark Williams-Cook氏が考案した、冗談の仕様ファイルです。robots.txtやllms.txtと同様にドメインのルートに置き、サイトに関連付けた猫の名前・役職・品種と、「PurrLevel」と呼ばれる10点満点の愛情指標を記載します。llms.txtの効果を裏付けるとされてきた”証拠”の妥当性を検証する目的で作られました。
Q2: この実験は、llms.txtが効果がないと証明したのですか?
いいえ。Williams-Cook氏自身が「llms.txtが決して機能しないと主張しているのではない」と明言しています。実験が示したのは、llms.txtの効果を裏付けるとして挙げられてきた「クロールされた」「インデックスされた」「LLMが言及した」「AIに聞いたら役立つと答えた」という4つの現象が、いずれもそれ単体では効果の証明にならないという点です。
Q3: 実務者はこの記事から何を判断材料にすればよいですか?
施策の”観測結果”(クロールされた、インデックスされたなど)と”効果”(引用や流入、コンバージョンの増加など)を明確に分けて記録し、AIチャットボットへの質問への回答を効果の証拠として扱わないことが挙げられます。llms.txt導入自体を否定する内容ではないため、導入する場合も効果測定の設計とあわせて行うことが望ましいとされています。
出典:How Cats.txt Showed LLMs.txt Evidence Is GEO Astrology(Search Engine Journal、Mark Williams-Cook氏、2026年8月7日)https://www.searchenginejournal.com/how-cats-txt-showed-llms-txt-evidence-is-geo-astrology/584653/
無料ダウンロード資料
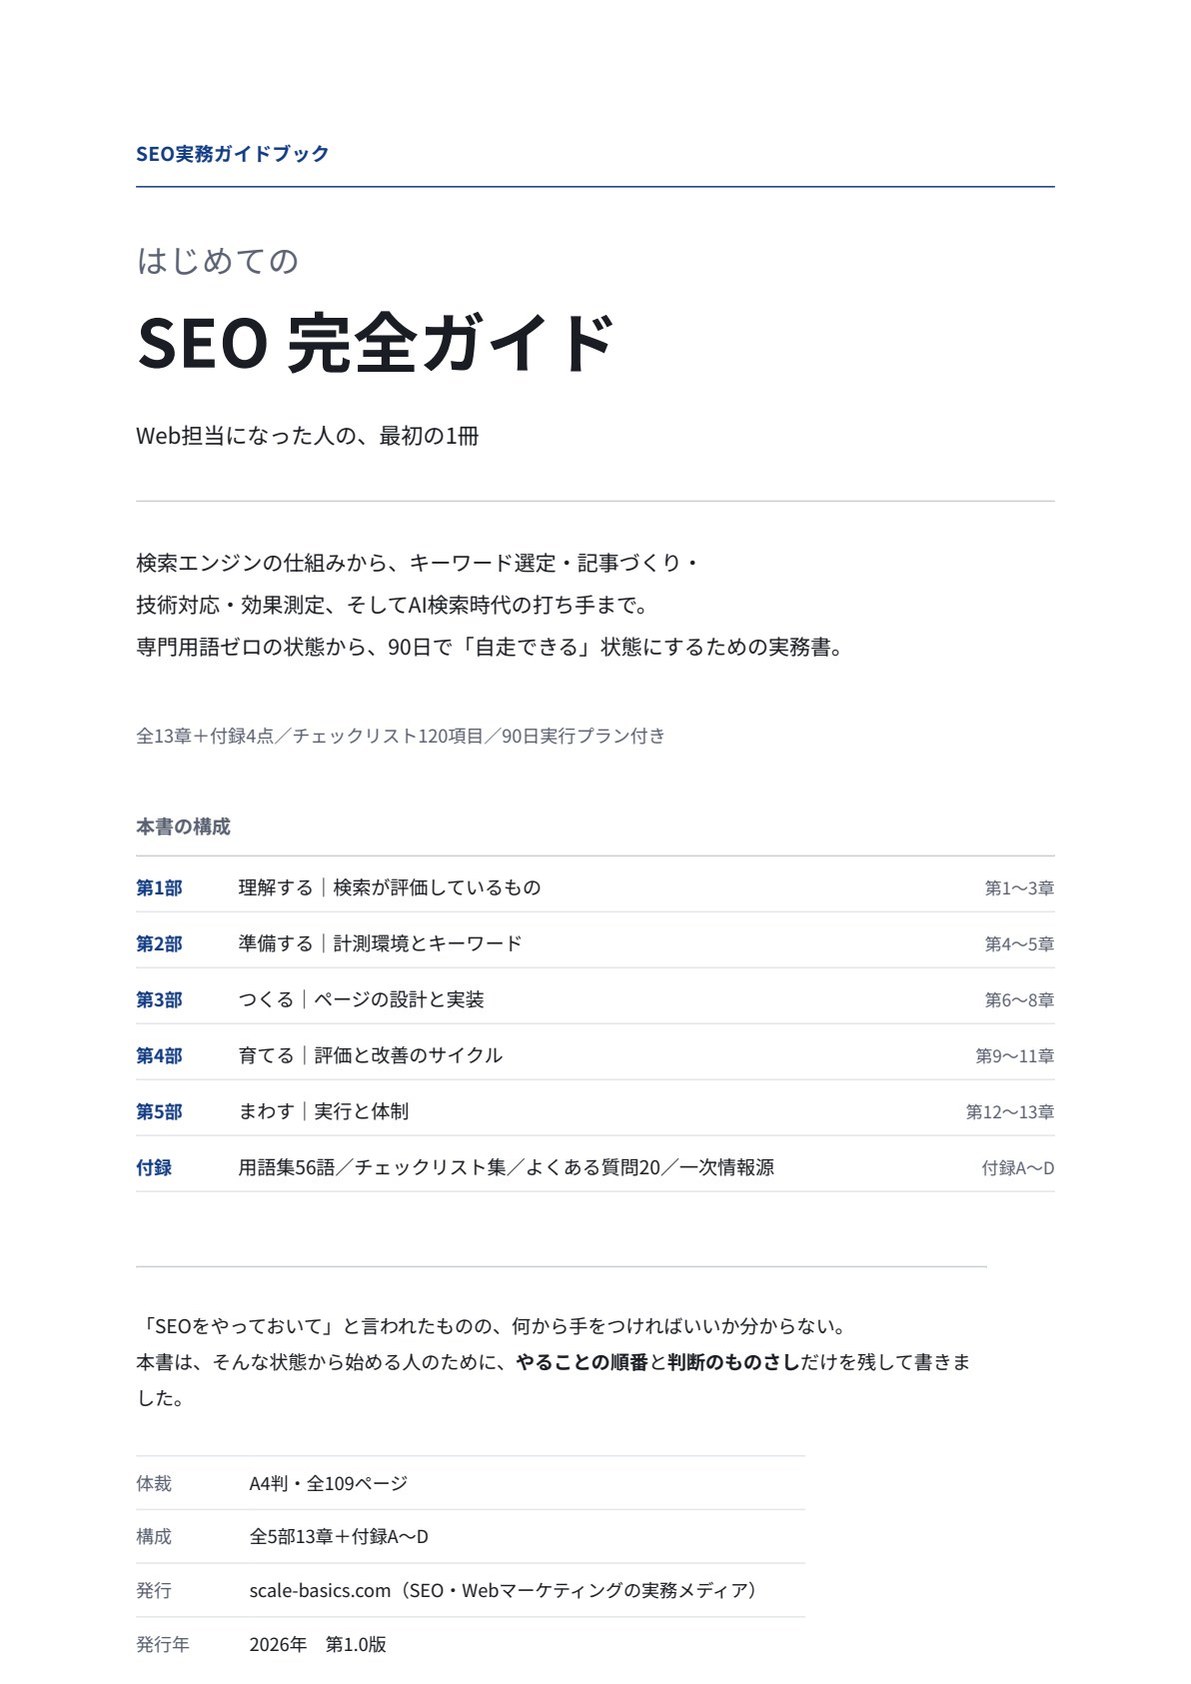
はじめてのSEO 完全ガイド
Web担当になった人が、90日で自走するための実務書
検索エンジンの仕組みから、キーワード選定・記事づくり・技術対応・効果測定、 そしてAI検索時代の打ち手まで。専門用語の知識ゼロの状態から読み始められるよう、用語はすべて本文中で説明しています。
| 体裁 | PDF/A4縦・全109ページ |
|---|---|
| 収録 | 図解21点、チェックリスト120項目、90日実行プラン、用語集56語 |
※フォーム送信後、ご入力のメールアドレス宛にダウンロードリンクをお送りいたします。
こちらのフォームにご記入ください
入力は1分ほどで終わります。