この記事でわかること
スクレイピングそのものを禁じる法律は日本になく、適法性は著作権法・利用規約・業務妨害・不正競争防止法・個人情報保護法という5つの枠組みで、取得の仕方と取得後の使い方の両面から個別に判断されます。
- 01判断は5つの枠組み違法かどうかを一括で決める条文はありません。著作権・利用規約・業務妨害・不正競争防止法・個人情報保護法を、それぞれ別に確認していく作業になります。
- 02著作権法30条の4情報解析のための利用は原則として認められます。ただし文化庁は、享受の目的がひとつでも含まれれば同条の要件を欠くとしており、内容そのものを使う意図が混ざれば適用されません。
- 03robots.txtは法律ではないrobots.txtは技術仕様であって法的な強制力はありません。一方で利用規約は契約なので、違反すれば債務不履行として損害賠償やアカウント停止の対象になり得ます。
- 04負荷が最大の実務リスク岡崎市立中央図書館の事例では、攻撃の意図がなく原因が相手側システムの不具合でも、逮捕と21日間の勾留に至りました。悪意がないことは守りになりません。
- 05取得と公開は別問題社内分析のための取得が認められても、公開や再配布は別に評価されます。そして最短の安全策は、そもそも公式APIが用意されていないかを先に探すことです。
結論|スクレイピング自体を禁じる法律はないが、5つの論点がある
まず前提として、「Webスクレイピングを禁止する」と定めた法律は日本には存在しません。問題になるのは、次の5点のいずれかに引っかかる場合です。表の右端には、着手前に「どこを見れば確認できるか」を添えました。
| 論点 | 関係する枠組み | 典型的にまずいケース | 事前に確認する場所 |
|---|---|---|---|
| 1. 著作物の利用 | 著作権法 | 取得した記事本文をそのまま自社サイトに掲載する | 取得後の使い道(社内分析か、公開・再配布か) |
| 2. 契約違反 | サイトの利用規約 | 規約で自動取得を禁じているサイトから取得する | 利用規約・サイトポリシー・robots.txt |
| 3. 業務妨害 | 刑事責任 | 過剰なアクセスで相手のサーバーに障害を起こす | アクセス間隔・同時接続数・実行する時間帯 |
| 4. データの不正取得 | 不正競争防止法 | IDとパスワードで管理されたデータを不正に取得する | 対象ページにログインが必要かどうか |
| 5. 個人情報 | 個人情報保護法 | 氏名や連絡先を含むデータを収集して利用する | 取得項目の設計(列に個人情報が入るか) |
ここで押さえておきたいのは、評価の対象が「どう取るか」と「取ったあとどう使うか」の二段構えになっていることです。論点3と4は取得の仕方の問題、論点1と5は取得後の使い方の問題、論点2は両方にまたがります。裏を返せば、この5点をクリアできるなら、スクレイピングは実務上の選択肢として成立します。順に見ていきます。
論点1|著作権法:情報解析目的なら原則として認められる
ウェブページ上の文章や画像は、多くの場合著作物です。それを複製する行為は、原則として著作権者の許諾が必要になります。ただし著作権法には、許諾なしに利用できる場合を定めた規定(権利制限規定)があり、スクレイピングに直接関わるのが第30条の4です。
著作権法 第30条の4|「享受を目的としない利用」
文化庁は、この条文について次のように説明しています。
「著作物は、技術の開発等のための試験の用に供する場合、情報解析の用に供する場合、人の知覚による認識を伴うことなく電子計算機による情報処理の過程における利用等に供する場合その他の当該著作物に表現された思想又は感情を自ら享受し又は他人に享受させることを目的としない場合には、その必要と認められる限度において、利用することができることを規定」
この規定は平成31年(2019年)1月1日に施行されました。ポイントは「情報解析の用に供する場合」が明示的に挙げられていることです。大量のページを取得して統計を取る、傾向を分析する、AIの学習データにするといった使い方は、著作物の表現内容を楽しむための利用ではないため、原則としてこの規定の対象になります。
「享受目的」が混ざると適用されない
ただし、ここには重要な限定があります。文化庁が令和6年(2024年)3月に取りまとめた「AIと著作権に関する考え方について」では、この点が明確に述べられています。
「複数の目的のうちにひとつでも享受の目的が含まれていれば同条の要件を欠くこととなり、ある利用行為が情報解析の用に供する場合などの非享受目的で行われる場合であっても、非享受目的と併存して享受目的があると評価される場合は、法30条の4は適用されない」
この考え方の前提として、同資料は、非享受目的の行為は「著作権者の利益を通常害するものではないと考えられるため、当該行為については原則として権利制限の対象とすることが正当化できる」としています。逆に言えば、「解析のため」と説明していても、実際には内容そのものを利用する意図が混ざっていれば、この規定には乗れないということです。
実務に引き直すと、次のような線引きになります。判断の分かれ目は「取得したものを、人が読んで味わう形のまま外に出すかどうか」だと考えると整理しやすくなります。
- 比較的リスクが低い:競合サイトの記事本数や更新頻度を集計する/価格の推移を統計として分析する/見出し構成の傾向を調べる
- リスクが高い:取得した記事本文をそのまま自社サイトに転載する/要約と称して表現をほぼそのまま使う/画像をダウンロードして自社コンテンツに使う
著作権法 第47条の5|検索・解析結果に付随する「軽微利用」
もう一つ関係するのが第47条の5です。文化庁の説明は次のとおりです。
「電子計算機を用いて、情報を検索し又は情報解析を行い、及びその結果を提供する者は、公表された著作物又は送信可能化された著作物について、その行為の目的上必要と認められる限度において、当該行為に付随して、軽微な利用を行うこと等ができることとしています」
こちらも平成31年(2019年)1月1日施行で、書籍検索サービスや論文剽窃検証サービスが例として挙げられています。検索結果にスニペット(抜粋)を表示するような使い方が、ここで言う「軽微な利用」に当たります。「軽微」の範囲を超えて本文を丸ごと見せてしまえば、この規定では正当化できません。
「取得」と「公開」は別の話
著作権の観点でもっとも実務的に重要なのは、取得する段階と、取得したものを外に出す段階を分けて考えることです。社内分析のために取得する行為が認められても、その内容を自社サイトで公開したり、データセットとして販売したりする行為は別途評価されます。「集めるところまでは大丈夫だった」という感覚で公開まで進めてしまうのが、もっともよくある失敗です。
設計の段階で、取得した原文を貯めるテーブルと、外部に出す成果物を最初から分けておくと事故が減ります。集計値(件数・平均・推移)だけを成果物側に流し、原文のテキストは分析用の領域に閉じておく、という切り分けです。
論点2|利用規約:robots.txtは法律ではない
著作権法上の問題がなくても、サイトの利用規約が自動取得を禁止していれば、それは契約上の問題になります。会員登録が必要なサービスであれば、登録時に規約へ同意しているため、違反した場合は債務不履行として損害賠償やアカウント停止の対象になり得ます。
規約を読むときは、「スクレイピング」という単語だけを探しても見つからないことが多い点に注意してください。実際には「自動化された手段」「ロボット」「クローラ」「プログラムによるアクセス」「複製・再配布」といった表現で書かれています。ページ内検索でこれらの語をひととおり当ててから、該当条項の前後を通して読むのが確実です。
robots.txtの位置づけ
ここで誤解が多いのがrobots.txtです。robots.txtは、クローラに対して「どこを巡回してよいか」を伝えるための技術的な取り決めであって、法律ではありません。仕様としては2022年にIETFのRFC 9309として文書化されていますが、これはあくまで技術仕様であり、従わなかった側に法的な制裁を課すものではありません。robots.txtで禁止されている場所を取得したからといって、それだけで直ちに違法になるわけではないのです。
ただし、実務上は次の意味で重視すべきです。
- サイト運営者の意思表示が明確に読み取れる(「ここは取りに来ないでほしい」という表明)
- 紛争になったとき、「相手の明示的な意思に反して取得を続けた」という評価につながり得る
- Crawl-delayなどの記述があれば、負荷をかけない実装の指針になる
「法的拘束力はないが、無視してよいものでもない」というのが正確な理解です。確認の手順は、対象サイトのトップページに「/robots.txt」を付けてアクセスするだけです。あわせて、フッターにある利用規約や「サイトポリシー」のページも必ず目を通してください。記述の読み方そのものはrobots.txtの書き方完全ガイドで解説しています。
迷ったら、守る側に立って考える
判断に迷ったときは、立場を入れ替えると答えが出やすくなります。自社サイトに同じ頻度・同じ作法でアクセスされたとき、それを歓迎できるかという基準です。ログに残るUser-Agentが何者か分からず、連絡先も辿れず、1秒に何度もリクエストが来る——そのアクセスを自分が受けたらブロックするはずです。ブロックされて当然のアクセスは、法的な評価を待つまでもなく、実務として成立しません。
論点3|業務妨害:悪意がなくても事件になった事例がある
スクレイピングで最も現実的なリスクが、アクセス負荷による業務妨害です。過剰なリクエストで相手のサーバーに障害を起こせば、偽計業務妨害や電子計算機損壊等業務妨害といった刑事上の問題に発展する可能性があります。
岡崎市立中央図書館事件(Librahack事件)
この論点を語るうえで避けて通れないのが、2010年に起きた岡崎市立中央図書館の事例です。経緯は次のとおりです。
- 2010年3月頃、岡崎市立図書館の蔵書検索システムでアクセス障害が発生
- 同年4月15日、図書館が愛知県岡崎警察署に被害届を提出
- 同年5月25日、蔵書検索システムに高頻度のリクエストを送ったとして、男性が偽計業務妨害容疑で逮捕
- 21日間の勾留を経て、同年6月14日に起訴猶予処分で釈放
この事例が今も繰り返し語られるのは、逮捕された人物に攻撃の意図がなく、しかも根本的な原因が図書館側のシステムの不具合にあったとされているためです。本人は新着図書のページを確認しやすくするためにクローラを作っていました。逮捕後、本人が「Librahack」というサイトを開設して経緯を説明したことから、Librahack事件とも呼ばれています。
ここから読み取るべき教訓は明確です。「自分は悪いことをしていない」という認識は、相手のサーバーが落ちたという事実の前では守りにならないということです。だからこそ、アクセス間隔を空ける、同時接続数を絞る、夜間などアクセスの少ない時間帯を選ぶ、といった実装上の配慮が単なるマナーではなく自衛策になります。
名乗り方が「正当なアクセス」かどうかを分ける
負荷と同じくらい重要なのが、正体を明かしているかどうかです。主要なクローラーの運営元は、自らの識別方法を公開して「これは正規のアクセスである」と検証できるようにしています。たとえばAppleは、Siri・Apple Intelligence向けのApplebotについてクロール元IPの一覧を公開しており、Applebotのクロール元IPが追加された際の公式の識別方法のように、変更があれば公表されます。サイト側はこの一覧と突き合わせて、名乗りが本物かどうかを確かめられます。
逆に言えば、実在するクローラーの名前を騙る、あるいは正体を隠して取得する行為は、区別されたうえで「隠す必要があった」と評価されかねません。User-Agentには自分の名前と連絡先のURLを入れ、相手が問い合わせられる状態にしておく。これが、負荷対策と並ぶもう一つの基本です。
論点4|不正競争防止法:「限定提供データ」に注意
平成30年の不正競争防止法改正で、「限定提供データ」という類型が新設されました。経済産業省の説明によれば、この改正は「ID・パスワード等により管理しつつ相手方を限定して提供するデータを不正取得等する行為を、新たに不正競争行為に位置づけ、これに対する差止請求権等の民事上の救済措置を設ける」ものです。
限定提供データに関する規定は2019年7月1日に施行されました。経済産業省は「限定提供データに関する指針」(平成31年1月23日策定、最終改訂は令和6年2月)も公表しています。
実務上のポイントは、ログインが必要なページから取得するケースです。誰でも見られる公開ページと、IDとパスワードで保護されたページとでは、リスクの水準が大きく変わります。会員向けに提供されているデータを自動取得して自社の事業に使う、といった行為は、この枠組みに触れる可能性があります。
判断の目安として、ログイン画面を一度でも通っているかどうかを、実装上の明確な分岐点にしておくことをおすすめします。ログインを伴う取得は、規約違反の可能性とこの論点が同時に立ち上がるため、少なくとも現場の自己判断だけで進めてよい領域ではありません。
論点5|個人情報保護法:氏名や連絡先が含まれる場合
取得するデータに氏名、メールアドレス、電話番号といった個人を識別できる情報が含まれる場合は、個人情報保護法の適用を受けます。公開されている情報であっても、個人情報であることに変わりはありません。
事業者として個人情報を取り扱う場合、利用目的をあらかじめ特定して通知または公表すること、目的の範囲を超えて利用しないこと、安全に管理することなどが求められます。「公開されていたから自由に使える」という理解は誤りです。制度の解説やガイドラインは個人情報保護委員会が公表しています。
実務では、そもそも個人情報を取得対象から外す設計にするのがもっとも簡単な回避策になります。企業名や商品情報の収集で足りるなら、氏名やメールアドレスの列は最初から取得しない設定にしておきます。担当者名が混ざりやすい「問い合わせ窓口」「執筆者」といった項目は、取得リストを作る段階で落としておくと後戻りがありません。
2026年の実務|ブロックは強まり、海外では法廷での線引きも進む
ここまでの5論点は法制度の話ですが、2026年に自動取得を行うなら、技術的にそもそも取れなくなってきているという現実も前提に入れる必要があります。
遮断はインフラ層に移っている
AIによる学習利用への警戒から、サイト運営者はCDNやWAFの設定でクローラーをまとめて遮断するようになりました。この動きは、正規の検索エンジンにまで影響が出るほど強くなっています。実際、CloudflareのAI学習ブロックでGooglebot・Bingbotがsitemap取得時に403を受け取る事象が報告されました。背景には非人間トラフィックの増加があり、Cloudflare CFOの「5年後、非人間トラフィックは人間の最大1,000倍」という発言も同じ文脈にあります。
実装側に必要なのは、「止められる前提」で組んでおくことです。403(拒否)や429(リクエスト過多)、503(一時的に利用不可)が返ってきたら、リトライを重ねずにその場で停止する。相手が明示的に拒否している状態で自動リトライを続ける挙動は、負荷の面でも、意思に反して取得を続けたという評価の面でも、最悪の組み合わせになります。
米国の訴訟が示した線引き(日本法の判断とは別)
海外では、スクレイピングの是非が実際に法廷で争われています。Googleが検索結果をスクレイピングして再販する事業者を訴えた裁判では、米連邦地裁が、ボット対策の仕組みが守っているのは広告収益であって著作物ではないとして、著作権の回避を理由とする主張を退けました。経緯はGoogleがスクレイピング訴訟で敗訴した件の解説にまとめています。
ただし、これは米国の法律についての判断であり、日本の著作権法や不正競争防止法の解釈をそのまま置き換えるものではありません。「アクセス制限を突破しても構わない」という一般則が導かれたわけでもありません。日本での判断は、あくまで本記事の5論点に立ち返って行ってください。海外の動向は、取得する側・される側の双方で線引きの議論が進んでいるという状況認識として押さえておけば十分です。
実行前チェックリスト
ここまでの5論点を、作業手順に落とし込むと次の10項目になります。着手前にすべて確認してください。番号の順に潰していくと、多くのケースは項目1か2の時点で結論が出ます。
10項目のうち1つでも未確認のまま走らせない。とくに項目1と2で止まるケースが多く、ここを飛ばすと後戻りが大きくなります。
- 1. 公式APIがないか探すAPIがあれば規約上も安全で、データも整形済みです。ここで解決するケースが実は多くあります。
- 2. 利用規約を読む自動取得・自動アクセス・データの二次利用に関する条項を探します。「ロボット」「自動化された手段」も検索語に入れます。
- 3. robots.txtを確認する対象URLがDisallowに含まれていないかを見ます。Crawl-delayの記述があれば、そのまま間隔の目安にします。
- 4. ログインが必要な領域かを確認する必要なら、不正競争防止法の「限定提供データ」の観点から慎重に判断します。
- 5. 個人情報が含まれるかを確認する氏名・メールアドレス・電話番号が入るなら、取得項目そのものから外せないかを先に検討します。
- 6. アクセス間隔と同時接続数を設定する1件ごとに待機を入れ、並列数を絞ります。相手のアクセスが少ない時間帯を選ぶのも有効です。
- 7. 連絡先の分かるUser-Agentを設定する名前と問い合わせ先を入れ、相手がいつでも連絡できる状態にします。他社クローラーの名前は騙りません。
- 8. エラーで止まる仕組みを入れる403・429・503が返ったら、リトライを重ねずに停止します。拒否されている状態での再試行が最も危険です。
- 9. 取得したデータの使い道を決めておく社内分析にとどめるのか、公開・再配布するのかで、著作権法上の評価が変わります。
- 10. 取得と公開を分けて再確認する公開する場合は、著作物をそのまま出していないか、集計値に置き換えられないかを点検します。
具体的なツールの選び方と、待機時間を入れた実装例はスクレイピングツールおすすめ7選にまとめています。ノーコードのツールにも間隔設定は必ず用意されているので、既定値のまま走らせないようにしてください。
よくある質問
Q1: 公開されているページなら自由に取得してよいですか?
「公開されている=自由に使える」ではありません。誰でも閲覧できるページであっても、掲載されている文章や画像には著作権があり、サイトの利用規約による制約もあります。取得の方法(アクセス頻度)と、取得後の使い方(社内分析か、公開か)の両面で判断してください。
Q2: robots.txtで禁止されている場所を取得すると違法ですか?
robots.txtは法律ではなく技術的な取り決めのため、それだけで直ちに違法とはいえません。ただし、サイト運営者の明確な意思表示であることに変わりはなく、紛争になった際に不利に働く可能性があります。特別な理由がない限り、記述には従うのが実務上の判断です。
Q3: 取得した情報を要約して自社サイトに載せるのは問題ありませんか?
「要約」と呼んでいても、元の表現をほぼそのまま使っていれば、著作物の利用にあたり得ます。文化庁の考え方でも、非享受目的と享受目的が併存する場合には著作権法30条の4は適用されないとされています。事実やデータ(数値そのもの)を自分の言葉で再構成し、出典を明示するのが安全な形です。
Q4: 取得したデータをAIの学習に使ってよいですか?
情報解析のための利用は著作権法30条の4の対象になり得ますが、これは著作権法上の評価であって、利用規約や個人情報保護法の論点は別に残ります。また文化庁の考え方では、享受の目的が併存すると評価される場合には同条は適用されないとされています。学習させたモデルの出力が元の表現に近づくことを想定した使い方であれば、非享受目的とは言いにくくなると解されます。
Q5: 個人でやる分には問題ありませんか?
規模が小さければリスクは下がりますが、ゼロにはなりません。岡崎市立中央図書館の事例は、営利目的ではない個人の取り組みが刑事事件に発展したケースです。個人か法人かではなく、相手に負荷をかけていないか、規約に反していないか、取得後にどう使うかで判断してください。
Q6: どこまで確認すれば「安全」といえますか?
本記事のチェックリストは、判断材料を漏れなく確認するためのものであり、適法性を保証するものではありません。同じ行為であっても、対象サイトの規約や取得後の使い方によって、ケースにより判断が分かれます。取引や事業の根幹に関わる規模でスクレイピングを行う場合や、判断に迷う要素がある場合は、事前に弁護士へ相談することをおすすめします。
まとめ|迷ったら、まず公式APIを探す
スクレイピングの適法性を判断する要点を整理します。
- スクレイピングそのものを禁じる法律は日本にはない。問題になるのは、著作権・利用規約・業務妨害・不正競争防止法・個人情報保護法の5論点
- 著作権法30条の4により、情報解析目的の利用は原則として認められる(平成31年1月1日施行)
- ただし文化庁は「ひとつでも享受の目的が含まれていれば同条の要件を欠く」としており、内容そのものを使う意図が混ざれば適用されない
- 第47条の5により、検索・解析結果に付随する「軽微な利用」は認められるが、本文を丸ごと見せる使い方は該当しない
- robots.txtは法律ではないが、サイト運営者の明確な意思表示であり、無視すべきではない
- 岡崎市立中央図書館の事例(2010年)では、攻撃の意図がなく原因が相手側システムの不具合でも、逮捕・21日間の勾留に至った
- ID・パスワードで管理されたデータの取得は、不正競争防止法の「限定提供データ」に触れる可能性がある(2019年7月1日施行)
- 個人情報が含まれるなら、そもそも取得項目から外す設計が最も簡単な回避策
- 「取得」と「公開」は別問題として、二段階で確認する
- 2026年はインフラ層での遮断が強まっている。403・429・503が返ったら止まる実装にしておく
もっとも実務的な結論を一つ挙げるなら、まず公式APIの有無を確認することです。APIが提供されていれば規約上の疑義がなく、データも整形済みで、相手のサーバーにも負荷をかけません。スクレイピングは、その手段がないときの次善策として位置づけるのが健全です。
SEOの調査目的であれば、そもそも自前で取得する必要がないケースも多くあります。被リンクや競合の流入キーワードはAhrefsのような専用ツールが正規のデータとして提供していますし、用途別の選び方はSEOツールおすすめ20選で整理しています。取りに行く前に、すでに提供されていないかを確認する。これが、法的リスクと実装コストの両方を同時に下げる、いちばん確実な手順です。
本記事は、文化庁「著作権法の一部を改正する法律(平成30年改正)」の解説および文化庁「AIと著作権について」(「AIと著作権に関する考え方について」令和6年3月・文化審議会著作権分科会法制度小委員会)、経済産業省「限定提供データと利活用」および同省「限定提供データに関する指針」(平成31年1月23日策定、最終改訂 令和6年2月)の公表内容にもとづき、2026年8月22日時点の情報で作成し、2026年9月5日に記載内容を見直しました。引用箇所は各資料の記載をそのまま用いています。法令・ガイドライン・各サイトの利用規約は改正・改定されることがあるため、実行前に必ず最新の内容をご確認ください。本記事は一般的な情報提供を目的としたものであり、法的助言ではありません。個別の案件については、必ず弁護士等の専門家にご相談ください。
無料ダウンロード資料
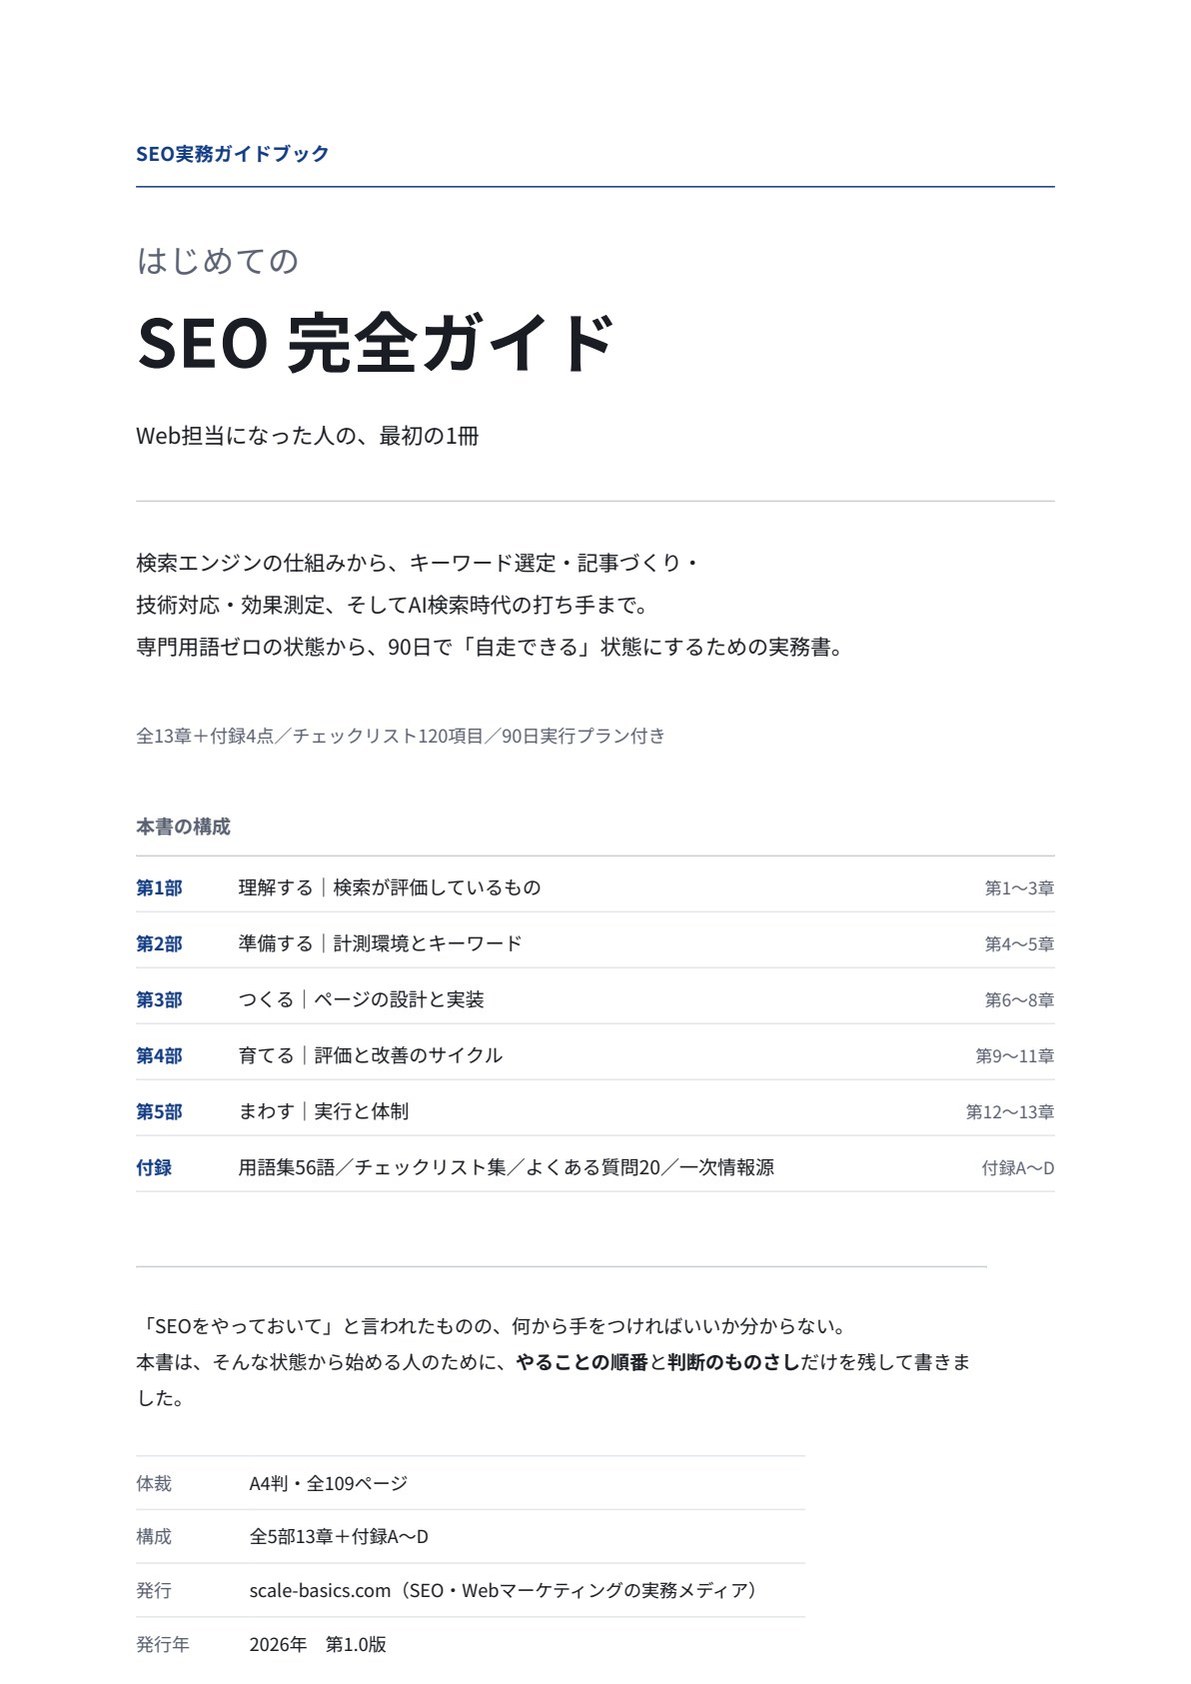
はじめてのSEO 完全ガイド
Web担当になった人が、90日で自走するための実務書
検索エンジンの仕組みから、キーワード選定・記事づくり・技術対応・効果測定、 そしてAI検索時代の打ち手まで。専門用語の知識ゼロの状態から読み始められるよう、用語はすべて本文中で説明しています。
| 体裁 | PDF/A4縦・全109ページ |
|---|---|
| 収録 | 図解21点、チェックリスト120項目、90日実行プラン、用語集56語 |
※フォーム送信後、ご入力のメールアドレス宛にダウンロードリンクをお送りいたします。
こちらのフォームにご記入ください
入力は1分ほどで終わります。